【2026年最新】四分位範囲の求め方!奇数・偶数の計算公式と箱ひげ図
高校数学の「データの分析」やビジネスでの統計実務において、データのばらつきを把握する基本指標として頻出するのが「四分位範囲」です。平均値や標準偏差だけでは捉えきれないデータの偏りを可視化する際に欠かせない概念ですが、「データの個数が奇数のときと偶数のときで、中央値の扱いが分からなくなる」「第1四分位数と第3四分位数の具体的な出し方で迷う」という声が今なお多く聞かれます。
データの個数による計算パターンの違いや公式の仕組みさえ整理してしまえば、手計算でも数分で正確な値を導き出せます。本記事では、四分位範囲の基礎公式から奇数・偶数別の求め方、箱ひげ図の読み方、さらにはExcel(QUARTILE関数)での算出法まで、現場のデータ分析にも直結する形でわかりやすく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:四分位範囲は「第3四分位数($Q_3$)- 第1四分位数($Q_1$)」で算出され、極端な外れ値の影響を受けにくい頑健な散布度を表す。
- 要点2:計算の最大の分岐点はデータの個数であり、奇数の場合は中央値を除外して前後を分割、偶数の場合は中央で2等分してそれぞれのグループの中央値を求める。
- 要点3:箱ひげ図の「箱の長さ」そのものが四分位範囲を示し、1.5×IQRルールを用いることで客観的な外れ値の検出が可能になる。
【基礎知識】四分位範囲とは?公式と四分位偏差の意味を整理
四分位範囲(IQR: Interquartile Range)とは、データを小さい順に並べたときに、中央に位置する50%のデータがどれくらい散らばっているかを示す統計量です。最大値から最小値を引く単純な「データの範囲(レンジ)」とは異なり、極端に大きすぎる値や小さすぎる値(外れ値)に左右されにくいという大きな強みを持っています。
四分位範囲を理解するうえで基本となる公式は次の通りです。
【四分位範囲の公式】
四分位範囲($IQR$)= 第3四分位数($Q_3$)- 第1四分位数($Q_1$)
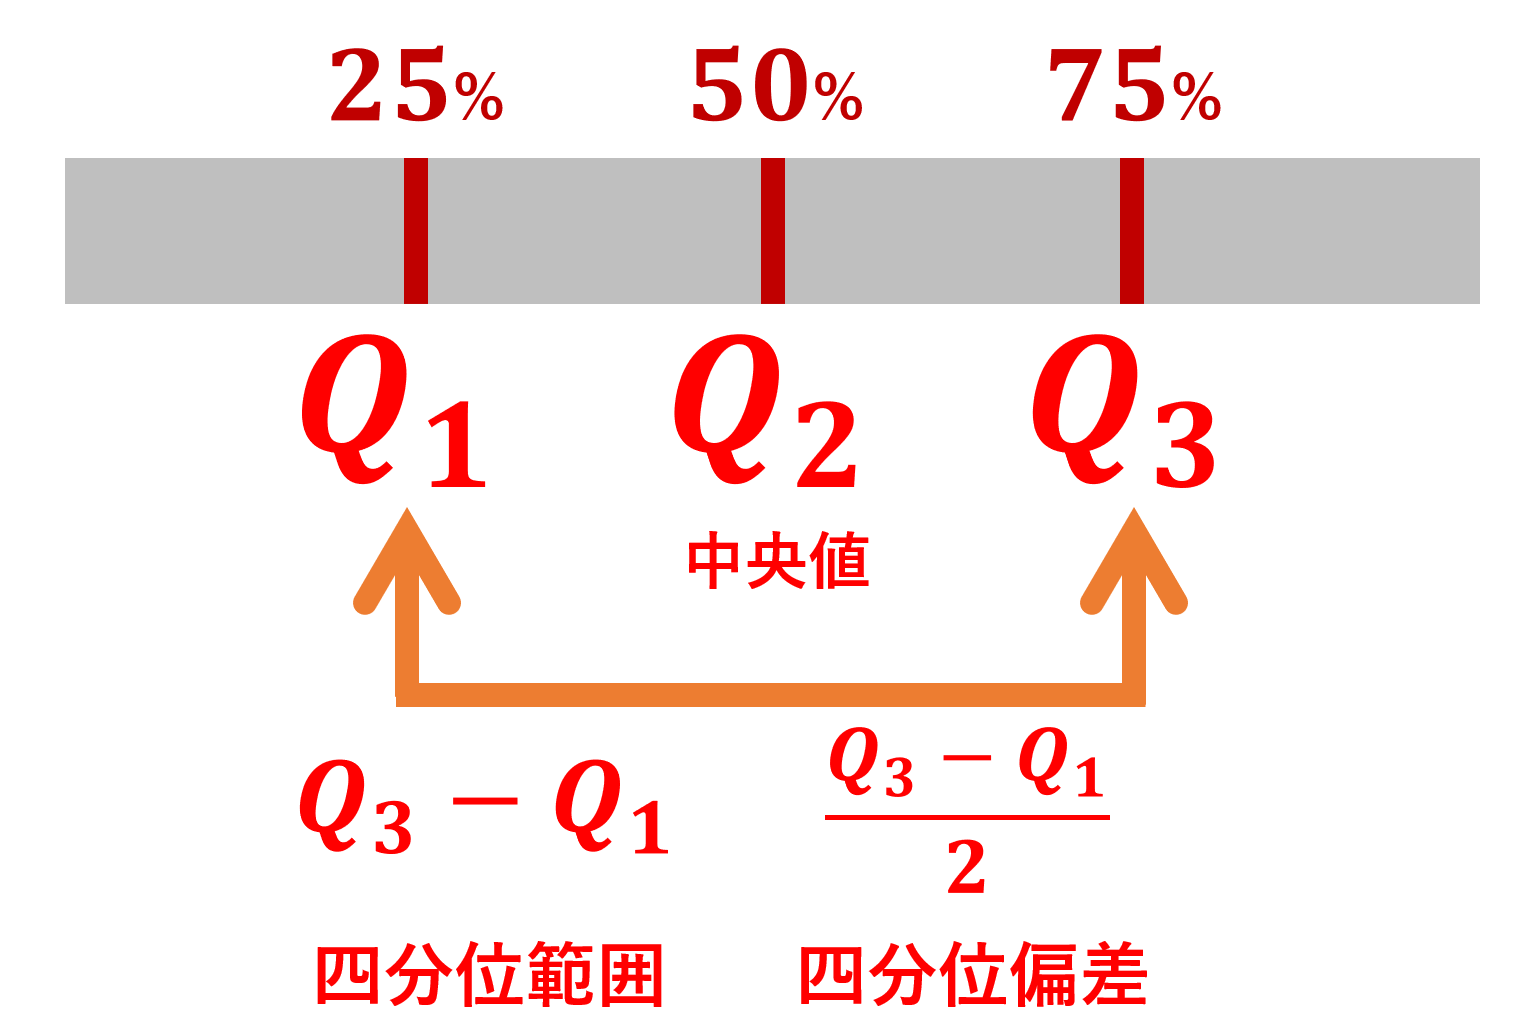
データを昇順に並べて4等分した際、小さい方から25%の位置にある値を「第1四分位数($Q_1$)」、50%の位置にある中央値を「第2四分位数($Q_2$)」、75%の位置にある値を「第3四分位数($Q_3$)」と呼びます。四分位範囲は、この$Q_3$から$Q_1$を引いた差分として定義されます。
あわせて覚えておきたいのが「四分位偏差(Quartile Deviation)」です。四分位偏差は四分位範囲を2で割った値であり、公式は以下のようになります。
【四分位偏差の公式】
四分位偏差 =(第3四分位数 - 第1四分位数)÷ 2 = $IQR / 2$
四分位偏差は、中央値からデータの散らばりがプラスマイナスどれくらい広がっているかの目安として用いられます。高校数学の定期試験や共通テストでも頻出の定義ですので、両者の違いを明確に区別しておきましょう。
【つまずき解消】データの個数が奇数・偶数での四分位数と中央値の計算手順
四分位範囲を求める際に最も多くの学習者がつまずくのが、「データの個数が奇数か偶数かによって手順がどう変わるのか」という点です。日本の高校数学(文部科学省の学習指導要領)で採用されている標準的な計算手順は、以下の3ステップで統一されています。
【共通ステップ】
1. データを小さい順(昇順)に並び替える。
2. 全体の中央値(第2四分位数 $Q_2$)を求める。
3. データを前半(下位)と後半(上位)のグループに分け、それぞれのグループの中央値を求める(前半の中央値が$Q_1$、後半の中央値が$Q_3$)。
ここでの重要分岐が、ステップ3における「全体の中央値($Q_2$)をグループに含めるかどうか」です。
① データの個数が「奇数」の場合:
中央の値が1つに確定します。この中央値そのものは除外し、それより前のデータ群を下位グループ、後のデータ群を上位グループとして2等分します。
② データの個数が「偶数」の場合:
中央値は中央の2つの値の平均値となります。このとき、データは綺麗に真ん中で2等分できるため、中央値の算出に使った2つの数値をそれぞれのグループに含めたまま、下位グループと上位グループに分割します。
この「奇数なら中央値を取り除いて左右に分ける」「偶数なら綺麗に半分に割る」というシンプルな原則さえ頭に入れておけば、計算で迷うことは一切なくなります。
【実践例題】手計算でマスターする四分位範囲の求め方
具体的な数値を使った例題で、奇数パターンと偶数パターンの計算手順を実際に確認してみましょう。
【例題1:データ数が奇数のケース(7個のデータ)】
対象データ:[12, 3, 7, 19, 5, 15, 9]
手順1(並び替え):
小さい順に並べます → [3, 5, 7, 9, 12, 15, 19]
手順2(中央値の決定):
データ数は7個(奇数)なので、真ん中の4番目にある「9」が中央値($Q_2$)です。
手順3(グループ分けと$Q_1$, $Q_3$の算出):
中央値「9」を除外して2分割します。
・下位グループ:[3, 5, 7] → 中央値は 5(第1四分位数 $Q_1$)
・上位グループ:[12, 15, 19] → 中央値は 15(第3四分位数 $Q_3$)
手順4(四分位範囲の計算):
$IQR = 15 - 5 =$ 10
(四分位偏差は $10 ÷ 2 =$ 5)
【例題2:データ数が偶数のケース(8個のデータ)】
対象データ:[20, 4, 16, 8, 12, 2, 18, 10]
手順1(並び替え):
小さい順に並べます → [2, 4, 8, 10, 12, 16, 18, 20]
手順2(中央値の決定):
データ数は8個(偶数)なので、中央の2つ(4番目の10と5番目の12)の平均が中央値です。
中央値 $Q_2 = (10 + 12) ÷ 2 = 11$
手順3(グループ分けと$Q_1$, $Q_3$の算出):
データを前後4個ずつにそのまま分けます。
・下位グループ:[2, 4, 8, 10] → 中央値は $(4 + 8) ÷ 2 =$ 6(第1四分位数 $Q_1$)
・上位グループ:[12, 16, 18, 20] → 中央値は $(16 + 18) ÷ 2 =$ 17(第3四分位数 $Q_3$)
手順4(四分位範囲の計算):
$IQR = 17 - 6 =$ 11
(四分位偏差は $11 ÷ 2 =$ 5.5)
【箱ひげ図の読み方】四分位範囲と外れ値の検出ルール
四分位範囲を視覚的に表現する代表的なグラフが「箱ひげ図(ボックスプロット)」です。データの分布状況や対称性を一目で把握できるため、共通テストや実務のレポーティングで極めて重視されています。
箱ひげ図における各部位の対応関係は以下の通りです。
- 左端のひげの先端:最小値(※外れ値を除外した最小値)
- 箱の左端:第1四分位数($Q_1$)
- 箱の中の縦線:中央値(第2四分位数 $Q_2$)
- 箱の右端:第3四分位数($Q_3$)
- 右端のひげの先端:最大値(※外れ値を除外した最大値)
つまり、箱ひげ図における「箱の横幅(長さ)」そのものが四分位範囲を表しています。箱の幅が広ければデータの中央50%が広く分散しており、幅が狭ければ中央部分にデータが密集していることを意味します。
さらに、統計学やデータサイエンスにおいて外れ値を客観的に判定する基準として用いられるのが「1.5×IQRルール」です。
【外れ値の判定基準】
・下限境界値:$Q_1 - (1.5 \times IQR)$
・上限境界値:$Q_3 + (1.5 \times IQR)$
この下限境界値より小さい値、または上限境界値より大きい値が存在する場合、それらは「外れ値(異常値)」として箱ひげ図上で個別のプロット(点やバツ印)として描画されます。データクレンジングの現場でも頻出の手法です。
【Excel活用法】QUARTILE関数を使った実務での四分位範囲の出し方
業務で大量のデータを処理する場合、手計算ではなくExcelを活用するのが定石です。Excelには四分位数を求める専用関数として`QUARTILE.INC`と`QUARTILE.EXC`の2種類が用意されています。
【実務で四分位範囲を出す数式】
データ範囲が `A2:A100` に入力されている場合、四分位範囲を求める計算式は次のようになります。
=QUARTILE.INC(A2:A100, 3) - QUARTILE.INC(A2:A100, 1)
ここでポイントとなるのが、関数の選び方です。
・`QUARTILE.INC`(インクルーシブ):
0%(最小値)から100%(最大値)を含めてパーセンタイルを計算する関数。高校数学で学習する四分位数の考え方に近く、実務でも広く一般的に使用されます。
・`QUARTILE.EXC`(エクスクルーシブ):
0%と100%を除外し、データの内側に重きを置いて四分位数を補間計算する関数。サンプルサイズが小さい場合はエラー(#NUM!)が出やすいため注意が必要です。
旧バージョンの互換性用に関数 `QUARTILE` も残されていますが、現在のバージョンでは挙動が明確な `QUARTILE.INC` を指定するのが確実です。
【データの分析 数学】高校数学と統計実務で異なる四分位数の流儀に注意
最後に知っておくべき重要な背景として、「四分位数の計算アルゴリズムには複数の流儀が存在する」という事実があります。
日本の高校数学教科書で採用されているのは「ヒンジ法(テューキーの方法)」と呼ばれる、中央値で分割してそれぞれの中央値を拾う方式です。この方法は計算が直感的で手計算に向いています。
一方で、統計解析プログラミング言語のRやPython(NumPy, pandas)、あるいはExcelの補間アルゴリズムでは、パーセンタイルを線形補間する別の方式(計9種類以上の計算タイプが存在)がデフォルトで採用されているケースがあります。そのため、全く同じデータ群であっても、「高校の教科書通りの手計算」と「ソフトウェアの自動算出結果」でわずかに小数点以下の数値がズレる現象が起こり得ます。
試験対策としては文部科学省基準の「中央値でグループ分割する手順」を忠実に守り、実務分析においては「どのソフトウェアのどの定義(アルゴリズム)で計算されているか」を把握しておくことが、データリテラシーの観点から極めて重要です。
【四分位範囲の求め方】に関するよくある質問(FAQ)
Q1:四分位範囲の計算結果がマイナスの数値になることはありますか?
A1:四分位範囲がマイナスになることは絶対にありません。データは必ず小さい順に並べ替えて処理するため、第3四分位数($Q_3$)は常に第1四分位数($Q_1$)以上の値になります。もし計算結果がマイナスになった場合は、並び替えの誤りや引き算の順序($Q_1 - Q_3$ と逆にしていないか)を疑ってください。
Q2:四分位範囲と標準偏差はどのように使い分ければよいですか?
A2:データが正規分布(左右対称の綺麗な釣鐘型)に近い場合は、平均値と標準偏差を用いるのが適しています。一方、データに極端な外れ値が含まれている場合や、所得分布・アクセス数のように左右非対称に大きく歪んでいるデータの場合は、外れ値に強い中央値と四分位範囲を用いる方がデータの実態を正確に把握できます。
Q3:データ数が極端に少ない(3個や4個)場合でも四分位範囲は出せますか?
A3:定義上、手計算であればデータ数が3個や4個でも計算自体は可能です。例えば3個[1, 5, 9]の場合、中央値は5、下位グループ[1]の中央値は1、上位グループ[9]の中央値は9となり、四分位範囲は $9 - 1 = 8$ となります。ただし、データ数が少なすぎる状態での四分位数は標本誤差が大きいため、統計的な分析指標としての信頼性は低くなります。
まとめ:四分位範囲を使いこなしてデータの本質を見抜く
四分位範囲の求め方は、一見複雑に見えても「昇順に並べ替える」「中央値を見つける」「奇数・偶数のルールに従って2分割する」という3つのステップさえ把握していれば迷うことはありません。
データ社会が進展する現在、平均値という単一の指標だけに頼った判断は大きなリスクを伴います。四分位範囲や箱ひげ図を自在に使いこなし、データのばらつきや真のボリュームゾーンを正しく読み解く力をぜひ身につけてください。 (出典: 四 分 位 範囲 求め 方(Yahoo!ニュース))


最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。